Lab 3.3 - Lire le log de déploiement, et ce que .forceignore lui cache
Niveau : 3 Release Manager
Durée : ~25 min
Vous allez : lire correctement un log de déploiement, puis relire une Pull Request dont le contrôle échoue sur un champ qui est pourtant dans son diff, et trouver le fichier qui le cache.
La situation
Merger la correction de présentation de page de Mariia a démarré un job de déploiement. La plupart des gens regardent la couleur et passent à autre chose.
Un release manager le lit, parce que le log de déploiement est le seul endroit qui dise ce qui a réellement atteint l'org, et que l'écart entre cela et ce que vous pensiez livrer est l'origine des incidents.
Avant de commencer
- Lab 3.2 terminé : la correction de présentation de page de Mariia mergée dans
integration
Partie 1 : lire le log
1. Ouvrir le job
Onglet Actions de votre fork (votre copie personnelle du repository du cours sur GitHub, par
exemple github.com/my-username/sfdx-hardis-training), l'exécution Process Deployment
(sfdx-hardis) qui a démarré quand vous avez mergé.
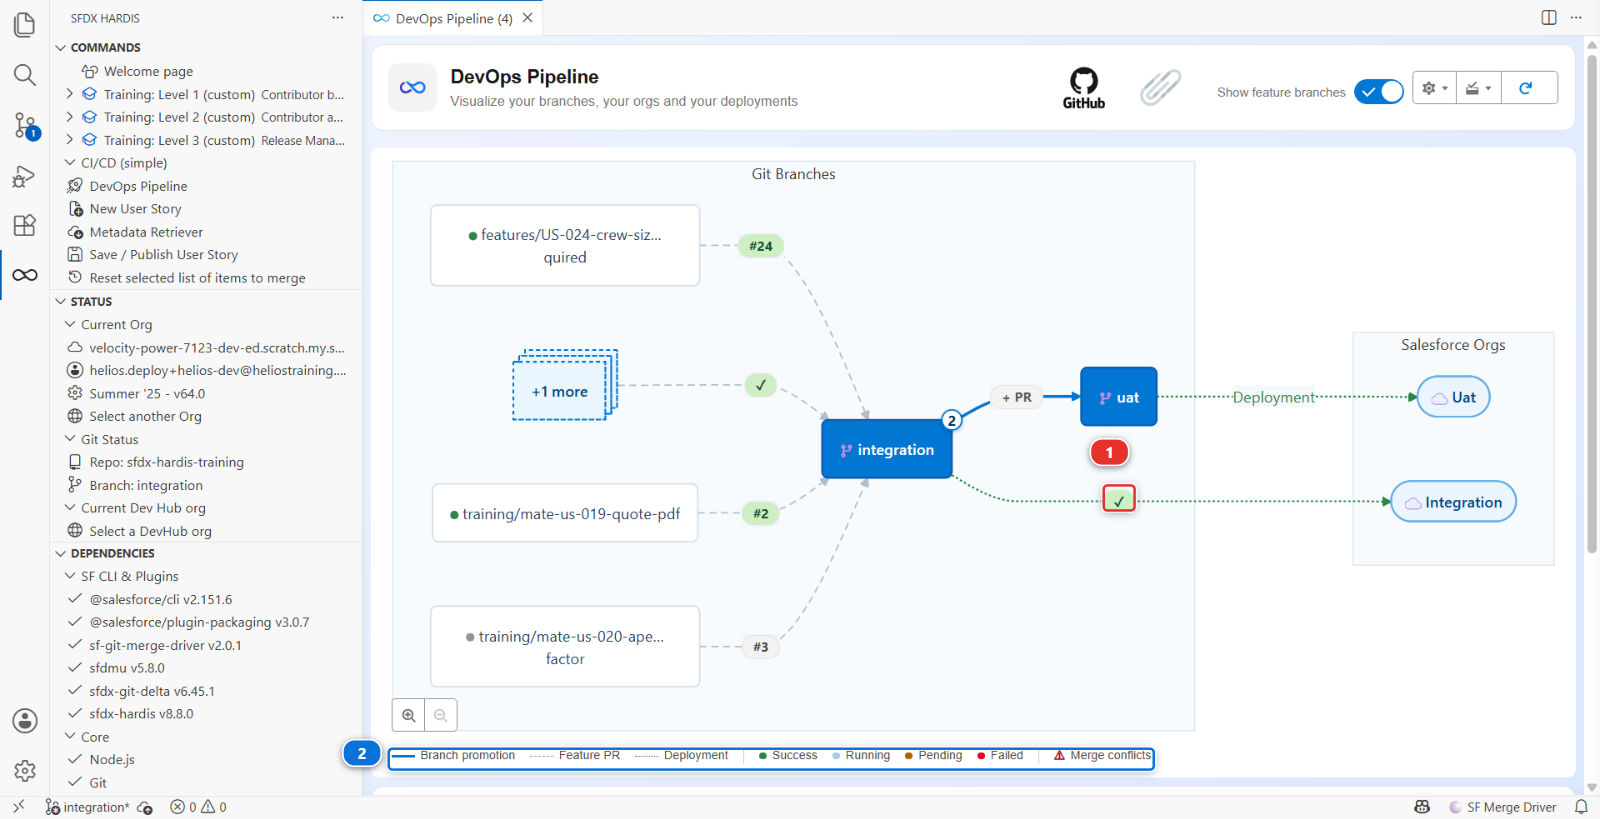
Ou depuis VS Code : le panneau DevOps Pipeline pose le job sur la flèche entre integration et
son org (1), coloré selon son statut, et la légende sous le diagramme (2) dit ce que signifie
chaque couleur. Cliquez sur le marqueur pour ouvrir l'exécution.
2. Le lire en cinq parties
Un log de déploiement sfdx-hardis a toujours la même forme :
Un : l'authentification. Quelle org, quel mécanisme. Après le Lab 3.1, il dit JWT. S'il dit un jour autre chose, c'est que quelque chose a changé sans que vous le changiez.
Deux : ce qu'il faut déployer. Le package qu'il a calculé, et d'où. C'est la partie intéressante et l'étape 3 en parle.
Trois : les actions pre-deploy. Tout ce qui est déclaré pour tourner avant, avec son résultat.
Quatre : le déploiement Salesforce. Composants déployés, tests lancés, couverture, durée. Sur un
job de merge, cherchez Deployment mode: FULL + Quick Deploy. Le job de contrôle de votre Pull
Request avait déjà validé ce package exact, tests compris, et le job de merge a demandé à Salesforce
d'appliquer cette validation plutôt que de redéployer. C'est pourquoi il prend quelques secondes, et
pourquoi il ne lance lui-même aucun test.
Cinq : les actions post-deploy, puis la notification.
3. Comprendre pourquoi le package est plus gros que le diff
Vous avez modifié un composant. Lisez maintenant ce que le job a réellement envoyé.
Ouvrez le package : panneau DevOps Pipeline, menu Deployment packages, Package XML. Il
liste toute l'application Helios, quelques dizaines de composants, et c'est cela le package : sur
ce projet chaque déploiement vers integration envoie le tout, quoi qu'ait dit le diff. Le compteur
de composants envoyés du log le dira.
C'est le comportement par défaut, et il vaut la peine de le ressentir une fois avant d'apprendre ce qui le corrige.
Le déploiement delta. Au lieu d'envoyer le package déclaré, sfdx-hardis calcule ce qui a changé entre le commit déjà déployé dans cette org et le nouveau, et n'envoie que cela. Un déploiement Salesforce complet d'un projet mature prend 40 minutes ; un delta en prend 3. La contrepartie est que l'org doit vraiment être au commit où la pipeline la croit.
Ce projet a le delta désactivé, exprès
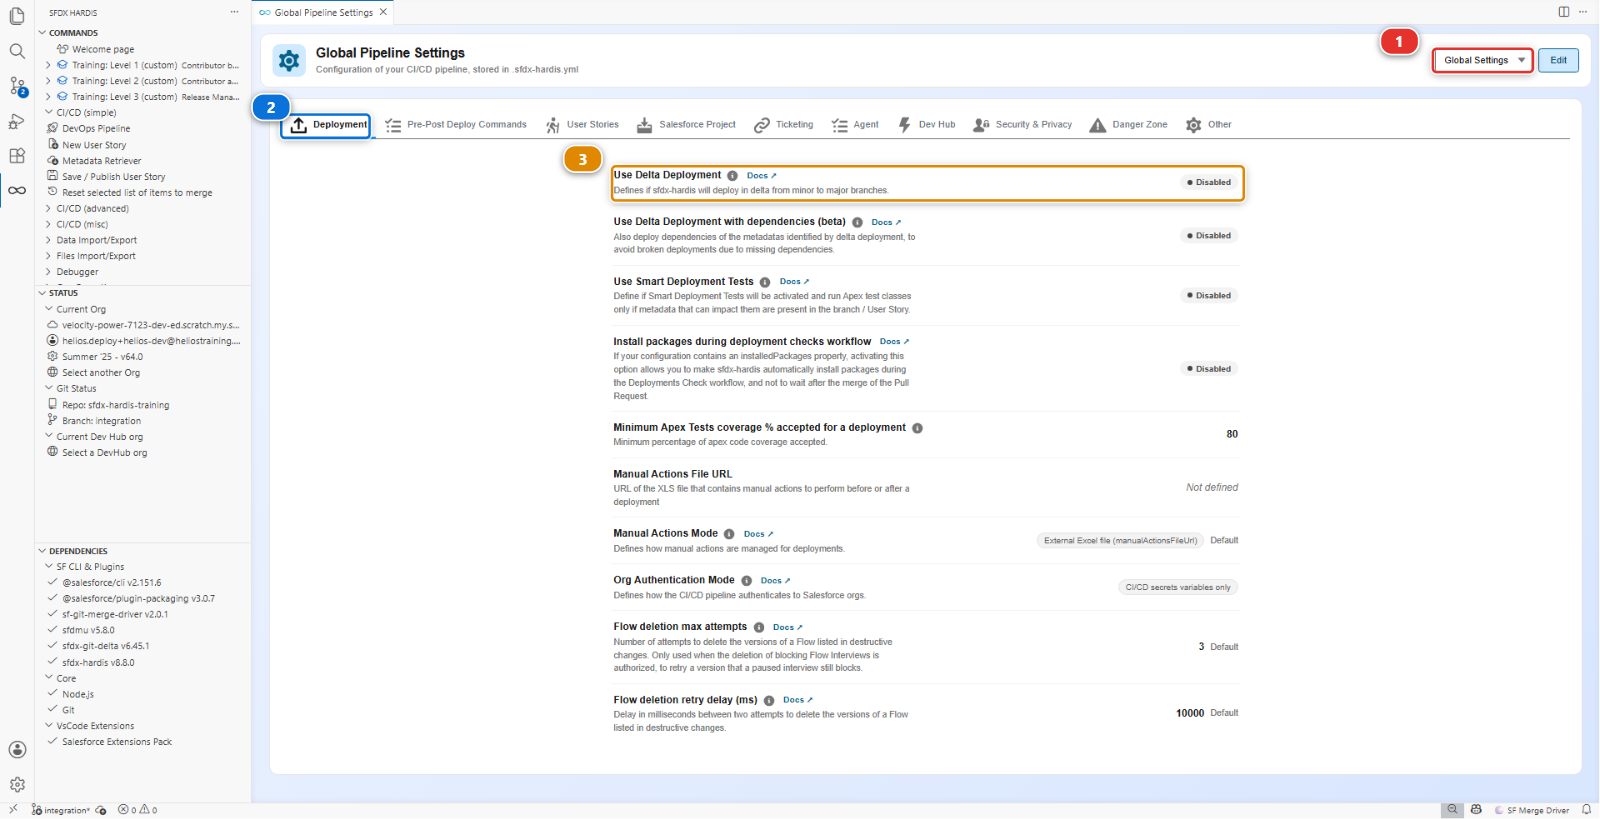
useDeltaDeployment est absent de config/.sfdx-hardis.yml : chaque déploiement de ce cours
envoie donc le package complet. Lisez-le vous-même : DevOps Pipeline, menu engrenage,
Pipeline Settings, portée Global Settings (1), onglet Deployment (2).
Use Delta Deployment (3) affiche Disabled.
L'application Helios fait une cinquantaine de composants : un déploiement complet coûte une
minute et le delta n'économiserait rien tout en ajoutant une façon pour le cours d'échouer de
manière déroutante sur une dépendance manquante. Activez-le quand un déploiement commence à vous
coûter du temps réel, ce qui sur un vrai projet arrive vite. Il y a une deuxième clé pour les
promotions entre branches majeures, enableDeltaDeploymentBetweenMajorBranches, dans l'onglet
Danger Zone, et elle est désactivée par défaut pour la même raison : une promotion transporte
davantage, et c'est l'endroit le plus risqué où en envoyer moins.
Trouvez la ligne Components: N deployed dans le log, sous Deployment summary. Sur une exécution
standard de ce cours, elle est un peu au-dessus de cinquante. Comparez-la avec l'unique fichier de
votre Pull Request. L'écart est le coût du delta désactivé, et c'est l'argument pour l'activer.
4. Savoir ce qu'est Smart Deploy, et ce qu'il n'est pas
"Smart Deploy" est le nom de la commande, pas celui d'un filtre. sf hardis:project:deploy:smart
est l'orchestrateur : il décide du package, réutilise un déploiement validé en Quick Deploy quand il
le peut, lance les actions pre et post déploiement, traduit les erreurs Salesforce en conseils, et
écrit le commentaire de la Pull Request. Il est intelligent sur le job, pas sur la comparaison
entre votre repository et l'org composant par composant.
Deux choses qu'on suppose souvent en faire partie et qui n'en font pas partie :
- Rien ne compare chaque composant à l'org pour écarter les identiques. Il existe un mécanisme
optionnel qui en fait quelque chose d'approchant,
manifest/packageDeployOnChange.xml, et il ne regarde jamais que les composants listés dans ce fichier. Le fichier n'existe pas dans ce projet, et il ne fait rien tant qu'il n'existe pas - Le nettoyage n'est pas un filtre de déploiement. Il a tourné sur la machine d'un contributeur, au moment du commit. L'étape 3 de la section sous le capot ci-dessous en parle
La réponse honnête à "pourquoi a-t-il déployé cinquante composants pour en changer un" est donc : parce que rien n'a été configuré pour l'en empêcher. C'est une décision de ce projet, pas quelque chose que l'outil fait pour vous.
5. Vérifier dans l'org, pas dans le log
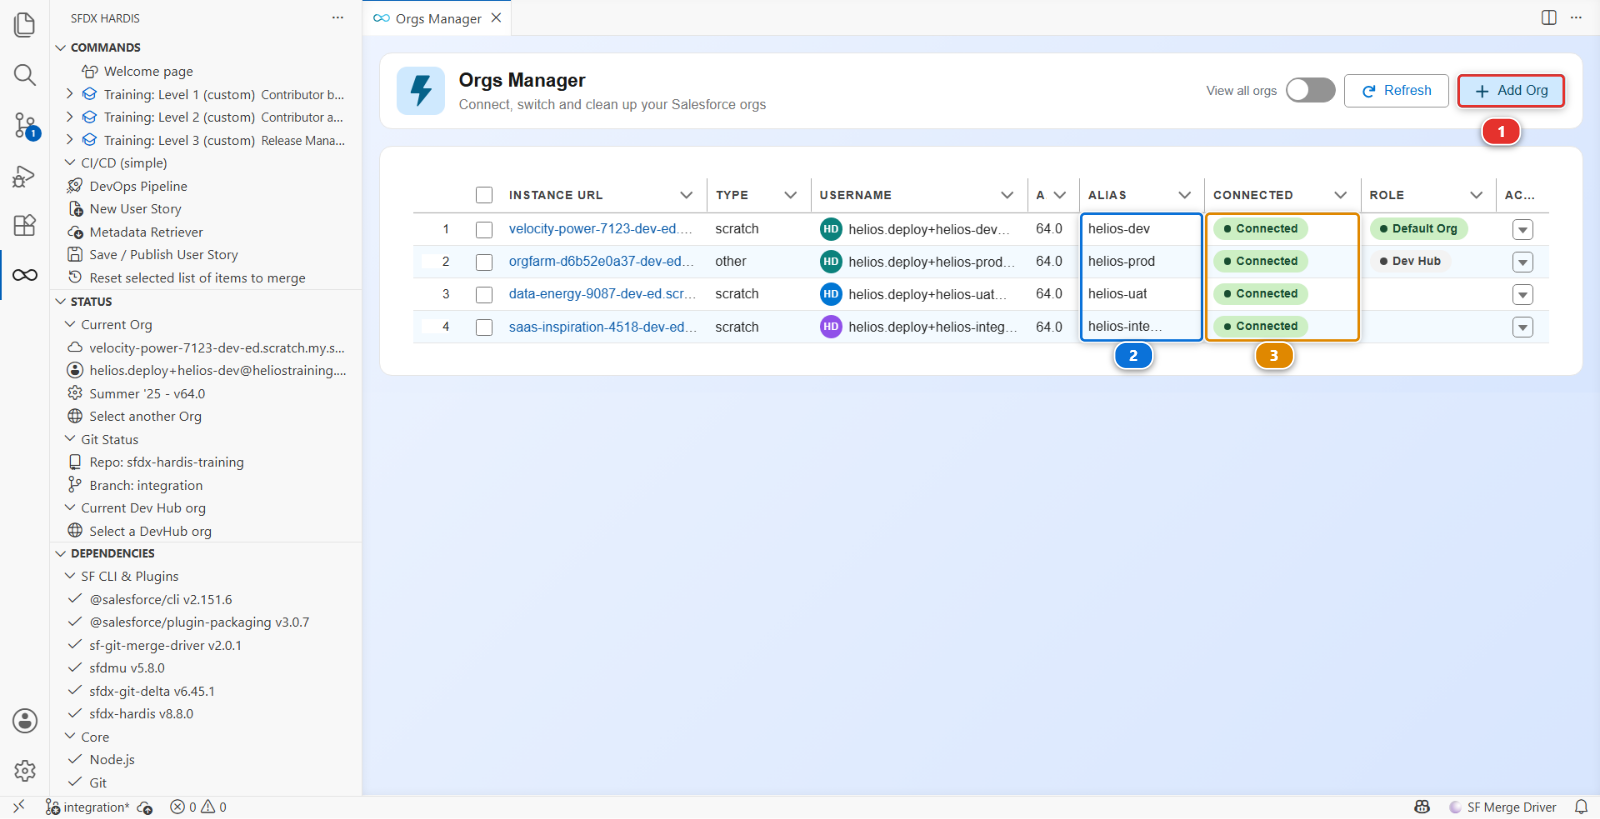
Ouvrez helios-integration depuis Orgs Manager : trouvez-la par son alias (2), vérifiez
qu'elle dit toujours Connected (3), puis Open dans le menu d'actions au bout de sa ligne.
Si elle dit déconnectée à la place, ce même menu propose Reconnect, et Add Org (1) est la
façon de connecter une org que le tableau n'a pas du tout.
Vérifiez que votre modification est bien là : ouvrez un enregistrement Installation, et Total Capacity (kW) est de retour sur la présentation de page, dans la colonne de droite à côté du champ de plafond de Mariia.
Un log est une affirmation. L'org est le fait. Sur un vrai projet, vous vérifiez l'org après chaque déploiement vers un environnement majeur, et cela prend trente secondes.
Partie 2 : ce que .forceignore cache
6. Une Pull Request qui échoue sur un champ qu'elle transporte
Romain a une story pour les planificateurs. Training: Level 3 > Simulate my teammates, et
choisissez US-056 Show the panels each crew member has to lay. Cela ouvre sa Pull Request vers
integration.
Attendez ses contrôles. Le contrôle de déploiement échoue, et le commentaire sfdx-hardis nomme un champ :
Installation__c-Installation Layout In field: field - no CustomField named Installation__c.Crew_Workload__c found
Ouvrez maintenant Files changed. Crew_Workload__c.field-meta.xml y est, dans le diff. Le champ
est dans la Pull Request, et le déploiement dit qu'il n'existe pas.
7. Trouver ce que le déploiement n'a jamais vu
Quand un composant est dans la branche et pas dans le déploiement, le premier fichier à ouvrir est
.forceignore. Il dit à la CLI Salesforce ce qu'il faut ignorer à la récupération et au
déploiement, et un composant qu'il capture est invisible dans les deux sens, sans erreur ni
avertissement.
Le diff de Romain le modifie lui aussi :
# My scratch test fields, never versioned (Romain)
**/objects/Installation__c/fields/Crew_W*.field-meta.xml
Cette ligne est un motif, pas un nom de fichier. Le * tient lieu de n'importe quel texte : il
capture donc tout champ d'Installation dont le nom commence par Crew_W, son champ de test bricolé,
et Crew_Workload__c, le champ de sa propre story. Le déploiement l'a laissé de côté, la
présentation de page et le permission set qui s'en servent ont atteint l'org sans lui, et Salesforce
les a refusés.
.forceignore est un fichier à l'échelle du projet, et c'est au release manager de le garder : une
seule ligne négligente change ce que chaque déploiement envoie, pour tout le monde, à partir de là.
8. Le renvoyer avec la correction nommée
Laissez un commentaire de revue sur la ligne .forceignore du diff :
This wildcard also matches
Crew_Workload__c, the field of this story, so no deployment ever sends it. Name your test field exactly, with no*, so nothing else can match by accident.
Un chemin exact vieillit mal lui aussi, mais il vieillit bruyamment : le jour où le fichier disparaît, rien d'autre ne se met à être ignoré.
Romain répond : Simulate my teammates > US-056 Romain names his test field exactly in .forceignore. Cela ajoute son commit à la même Pull Request, le contrôle retourne, et il passe au vert. Lisez le diff de son nouveau commit, puis mergez.
Sous le capot : d'où vient le package, et où se fait vraiment le nettoyage
Le job a lancé :
sf hardis:project:deploy:smart
et le package qu'il a envoyé a été construit ainsi :
- Partir de
manifest/package.xml, le package déclaré, plusmanifest/destructiveChanges.xmlpour ce qui est retiré - Le delta, si
useDeltaDeploymentest activé :sfdx-git-deltacalcule les composants modifiés entre le dernier commit déployé etHEAD, et tout le reste est ressorti du package.enableDeltaDeploymentBetweenMajorBranchesdécide si la même chose s'applique à un déploiement de majeure à majeure, et est désactivé par défaut parce qu'une promotion vers la production est le pire endroit possible pour découvrir que l'org a dérivé - Le gestionnaire d'écrasement, si
manifest/package-no-overwrite.xmlexiste : l'org est interrogée, et tout composant listé dans ce fichier que l'org possède déjà est retiré. Il est limité à sa propre liste et à rien d'autre, et un composant qu'il protège est quand même créé dans une org qui ne l'a pas encore - Le deploy-on-change, si
manifest/packageDeployOnChange.xmlexiste : ces composants, et eux seuls, sont récupérés depuis l'org et comparés, et ceux qui n'ont pas changé sont écartés
Les étapes 2, 3 et 4 sont toutes désactivées dans ce projet : ce que Salesforce reçoit est donc l'étape 1.
Le nettoyage n'est pas dans cette liste, et c'est ce qu'il faut retenir. Les règles
autoCleanTypes tournent à l'intérieur de sf hardis:work:save, sur la machine d'un contributeur,
avant le commit. Elles réécrivent les fichiers sur le disque et commitent le résultat, c'est
pourquoi le Lab 1.5
a pu vous montrer le diff qu'elles ont produit. Au moment où un déploiement tourne, il n'y a plus
rien à nettoyer : le repository est déjà la version nettoyée.
Deux modes de défaillance à savoir reconnaître :
- L'org a dérivé. Quelqu'un a modifié quelque chose dans l'org à la main et le déploiement l'écrase sans un mot, parce que rien n'a comparé. Le Lab 3.7 parle de cela
- Le delta a perdu une dépendance. Votre modification a besoin d'un composant qui n'a pas changé,
le delta ne l'emporte donc pas, et le déploiement échoue sur une référence. La correction n'est pas
de désactiver le delta : c'est d'inclure la dépendance, ce à quoi sert
manifest/package.xml
Documentation des commandes : hardis:project:deploy:smart, hardis:work:save
Ce que vous devez voir
- Une exécution Process Deployment (sfdx-hardis) verte sur
integration - Un log où vous savez dire combien de composants sont partis, et pourquoi ce nombre n'est pas un
- La modification présente dans
helios-integration - La US-056 de Romain mergée,
Crew_Workload__cdanshelios-integration, et plus aucun joker dans.forceignore
En cas de problème
Le déploiement a échoué alors que le contrôle était passé. Quelque chose a changé entre les deux : l'org, ou un autre déploiement arrivé avant. Lisez l'erreur, et vérifiez si quelqu'un a déployé à la main.
Le log dit "nothing to deploy".
Avec le delta désactivé, cela ne devrait pas arriver sur ce projet, parce que le package est déclaré
et non calculé. Si cela arrive, vérifiez que manifest/package.xml est toujours dans la branche et
liste toujours quelque chose.
Le job n'a jamais démarré.
Le workflow ne se déclenche que sur les pushes vers des branches majeures. Vérifiez que le merge a
bien atterri sur integration.
Le contrôle de Romain échoue encore après son deuxième commit.
Le contrôle a tourné sur le merge de sa branche avec integration telle qu'elle était au moment de
son push. Si vous avez modifié .forceignore sur integration entre-temps, cliquez sur
Update branch sur sa Pull Request : GitHub y merge integration, et le contrôle retourne.
Vérifiez votre travail
Welcome page > Training: Level 3 > Check my work, puis choisissez le Lab 3.3.
Pour aller plus loin
Suite : Lab 3.4 - Trois Pull Requests se percutent : choisir l'ordre de merge